Operação consistente
Administração e atualização dos clusters com rotinas claras, configuração controlada e visão das dependências críticas.
Kubernetes & Cloud Native
Atuamos em clusters e workloads com foco em operação, GitOps, segurança, autoscaling, observabilidade e mudanças controladas, de acordo com a maturidade do seu time.
Clusters, workloads, exposição, observabilidade e mudanças controladas tratados como partes da mesma plataforma.
Kubernetes em produção
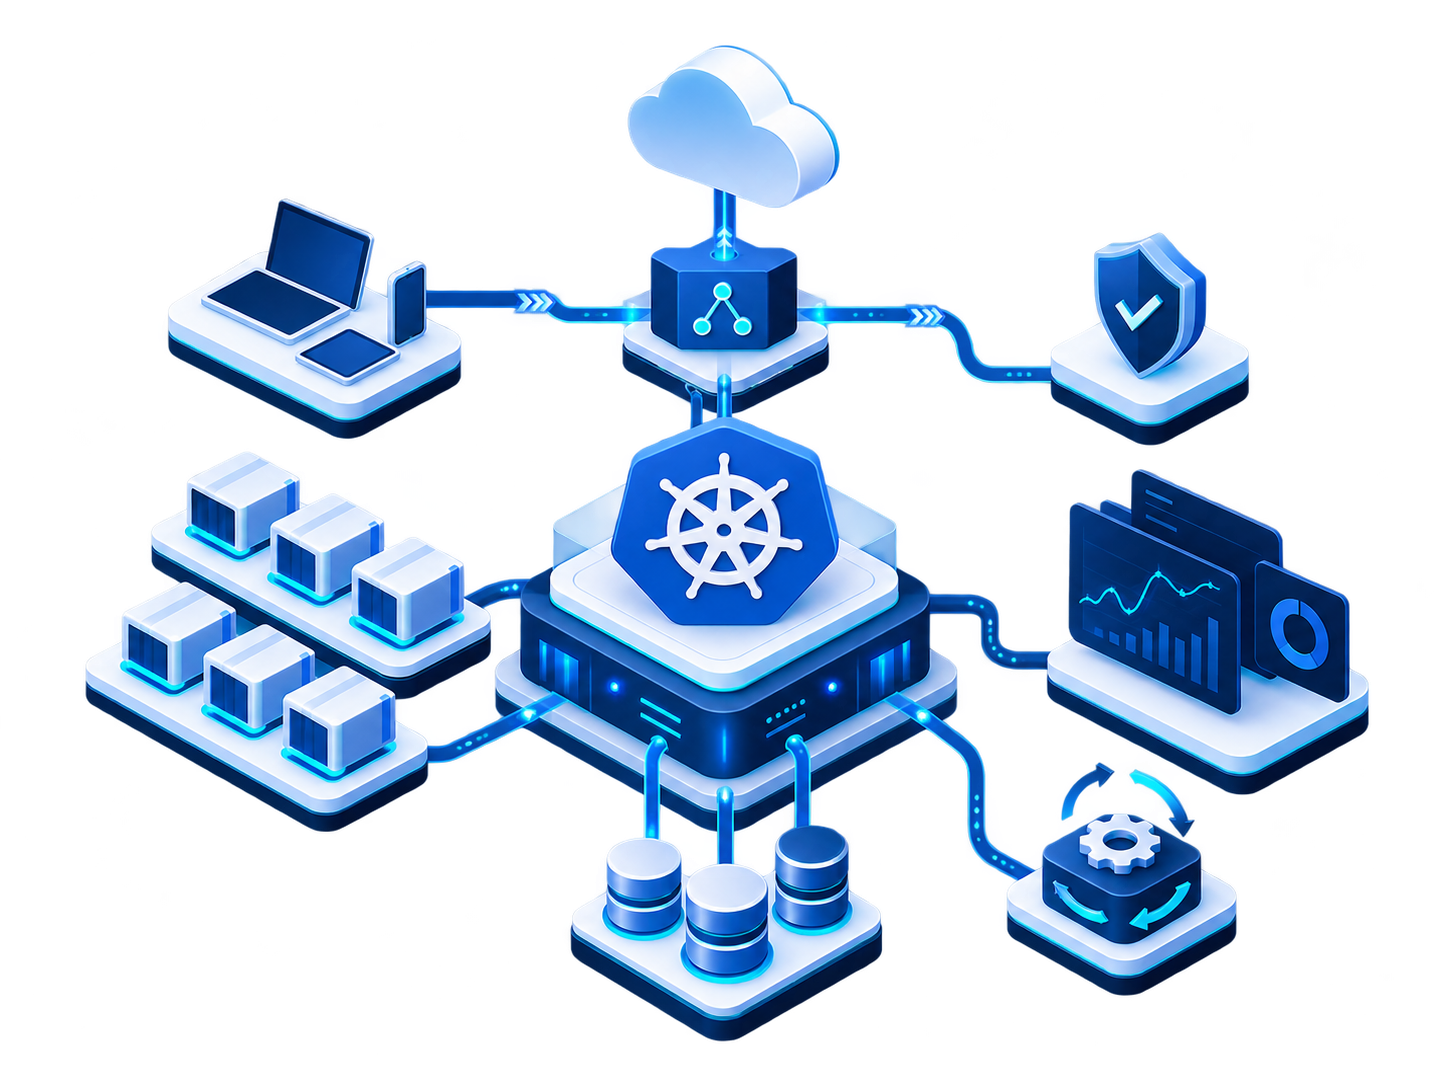
Clusters produtivos concentram decisões de disponibilidade, acesso, capacidade, rede e operação. A atuação organiza essas dependências para que a plataforma acompanhe aplicações e equipes com menos fragilidade.
Administração e atualização dos clusters com rotinas claras, configuração controlada e visão das dependências críticas.
Revisão de recursos, distribuição, políticas e comportamento das aplicações para reduzir pontos únicos de falha e interrupções evitáveis.
RBAC, hardening e certificados incorporados à operação para limitar exposição e reduzir riscos sem bloquear a evolução do ambiente.
Troubleshooting orientado por sinais do cluster e dos workloads para localizar gargalos, falhas de configuração e causas de instabilidade.
Atuação em diferentes plataformas Kubernetes
AWS
Azure
Entrega e operação cloud native
A plataforma ganha previsibilidade quando empacotamento, exposição, configuração e deploy seguem padrões versionados que as equipes conseguem compreender e sustentar.
01 · Empacotar
Charts e valores estruturam configurações reutilizáveis, revisáveis e adequadas às diferenças entre ambientes.
02 · Expor
A entrada de tráfego é organizada com regras claras de exposição, roteamento e integração com TLS.
03 · Entregar
O estado desejado permanece conectado ao repositório, dando histórico e consistência à promoção de mudanças.
04 · Operar
Sinais de produção alimentam troubleshooting, ajustes de capacidade e evolução dos padrões da plataforma.
Entenda o fluxo interno do Kubernetes após um kubectl apply.
Escala e proteção
Escalar com critério e restringir acesso com contexto evita que o crescimento da plataforma amplie custos, exposição ou instabilidade.
Escalabilidade inteligente
Autoscaling de workloads conecta sinais de demanda ao ajuste de réplicas e capacidade, respeitando limites e características das aplicações.
Segurança e governança
RBAC, hardening e Cert-Manager integram controles ao funcionamento cotidiano do cluster, reduzindo permissões excessivas, desvios e tarefas manuais com certificados.
Confiabilidade em evolução
A operação dos workloads e a modernização cloud native compartilham a mesma base: compreender comportamento, dependências e riscos antes de ampliar mudanças.
Operação
Métricas, logs e alertas do cluster e das aplicações ajudam a diferenciar falhas de infraestrutura, configuração e workload durante incidentes e análises preventivas.
Evolução
Aplicações podem evoluir para containers e Kubernetes com avaliação de dependências, requisitos operacionais e ganhos reais, sem pressupor microsserviços ou reescritas completas.
Resultados esperados
Experiência profissional anterior
Os exemplos representam desafios enfrentados ao longo da carreira do fundador, não cases ou contratos da Skynalytix.
Avaliações AWS e Azure envolvendo clusters, workloads, capacidade, segurança, networking e governança.
Provisionamento de aplicações Kubernetes com estratégia Blue/Green para controlar rollout e reduzir risco de publicação.
Adequação e limites
A avaliação considera requisitos, capacidade interna e complexidade antes de recomendar expansão, modernização ou simplificação.
Projetos em produção não significam plantão, operação permanente 24x7 ou garantia de zero downtime.
Próximo passo
Conte como o cluster opera hoje, o que precisa mudar e onde está o maior risco. A avaliação inicial organiza o contexto antes de qualquer investigação aprofundada.